Domain high-low.de kaufen?
Wir ziehen mit dem Projekt
high-low.de um.
Sind Sie am Kauf der Domain
high-low.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain high-low.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **

Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Günstig & gutGünstig & gut , Bedingt durch die massiven Teuerungen müssen viele Menschen sparen. Davon sind junge Familien gleichermaßen wie Pensionisten, Studenten oder Geringverdiener betroffen. Trotz gestiegener Lebensmittelpreise ist es dennoch möglich, gut und preiswert zu kochen. Im vorliegenden Buch finden sich rund 120 Rezepte für Suppen und Eintöpfe, für pikante Kürbis-Fleischbällchen, Putencurry, Champignonkuchen, herzhafte Strudel oder Nudel-Gerichte, für süße Hauptspeisen wie Schmarren, Scheiterhaufen, Schoko-Topfenknödel, sowie für Brot und Kleingebäck. Jedes Rezept wurde mehrfach getestet und ist absolut gelingsicher! , Zündvorrichtungen > Zünd- & Glühanlagen , Erscheinungsjahr: 20240823, Produktform: Leinen, Redaktion: Gimbutyte, Joana, Seitenzahl/Blattzahl: 144, Keyword: Rezepte wenig Geld; billig kochen; billige Gerichte; billige Rezepte; einfache Rezepte; erprobte Rezepte; gar es ohne Bares; gelingsichere Rezepte; gutes preiswertes Essen; günstig kochen; günstige Eintöpfe; günstige Gerichte; günstige Hauptspeisen; günstige Rezepte; günstige Suppen; günstige süße Hauptspeisen; günstiges Brot und Gebäck; günstiges Essen; günstiges Essen für jeden Tag; kochen mit wenig Geld; kochen ohne Kohle; preisewerte Gerichte für jeden Tag; preiswert kochen; preiswerte Aufläufe; preiswerte Eintöpfe; preiswerte Hauptspeisen; preiswerte Kartoffelgerichte; preiswerte Knödel; preiswerte Nudelgerichte; preiswerte One-Pot-Gerichte; preiswerte Rezepte, Fachschema: Kochen / Preisgünstig Kochen~Kochen / Allgemeines Kochbuch, Grundwissen~Kochen / Dessert, Süßspeise, Konfitüre, Konfekt, Fachkategorie: Kochen und Rezepte allgemein~Preisgünstig Kochen~Kochen: Hauptgerichte~Kochen: Desserts, Warengruppe: HC/Themenkochbücher, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 246, Breite: 172, Höhe: 13, Gewicht: 492, Produktform: Gebunden, Genre: Sachbuch/Ratgeber,20,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter



-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Angebotsbeschreibungen für Online-Einkaufsportale zur automatischen Klassifizierung und Informationsextraktion mittels RekursiverAngebotsbeschreibungen Für Online-einkaufsportale Zur Automatischen Klassifizierung Und Informationsextraktion Mittels Rekursiver Transitionsnetzwerke, Taschenbuch Von Anja Klein, Grin, 978-3-668-14793-5, Seitenanzahl: 6427,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Günstig & gutGünstig & gut , Bedingt durch die massiven Teuerungen müssen viele Menschen sparen. Davon sind junge Familien gleichermaßen wie Pensionisten, Studenten oder Geringverdiener betroffen. Trotz gestiegener Lebensmittelpreise ist es dennoch möglich, gut und preiswert zu kochen. Im vorliegenden Buch finden sich rund 120 Rezepte für Suppen und Eintöpfe, für pikante Kürbis-Fleischbällchen, Putencurry, Champignonkuchen, herzhafte Strudel oder Nudel-Gerichte, für süße Hauptspeisen wie Schmarren, Scheiterhaufen, Schoko-Topfenknödel, sowie für Brot und Kleingebäck. Jedes Rezept wurde mehrfach getestet und ist absolut gelingsicher! , Zündvorrichtungen > Zünd- & Glühanlagen , Erscheinungsjahr: 20240823, Produktform: Leinen, Redaktion: Gimbutyte, Joana, Seitenzahl/Blattzahl: 144, Keyword: Rezepte wenig Geld; billig kochen; billige Gerichte; billige Rezepte; einfache Rezepte; erprobte Rezepte; gar es ohne Bares; gelingsichere Rezepte; gutes preiswertes Essen; günstig kochen; günstige Eintöpfe; günstige Gerichte; günstige Hauptspeisen; günstige Rezepte; günstige Suppen; günstige süße Hauptspeisen; günstiges Brot und Gebäck; günstiges Essen; günstiges Essen für jeden Tag; kochen mit wenig Geld; kochen ohne Kohle; preisewerte Gerichte für jeden Tag; preiswert kochen; preiswerte Aufläufe; preiswerte Eintöpfe; preiswerte Hauptspeisen; preiswerte Kartoffelgerichte; preiswerte Knödel; preiswerte Nudelgerichte; preiswerte One-Pot-Gerichte; preiswerte Rezepte, Fachschema: Kochen / Preisgünstig Kochen~Kochen / Allgemeines Kochbuch, Grundwissen~Kochen / Dessert, Süßspeise, Konfitüre, Konfekt, Fachkategorie: Kochen und Rezepte allgemein~Preisgünstig Kochen~Kochen: Hauptgerichte~Kochen: Desserts, Warengruppe: HC/Themenkochbücher, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 246, Breite: 172, Höhe: 13, Gewicht: 492, Produktform: Gebunden, Genre: Sachbuch/Ratgeber,20,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
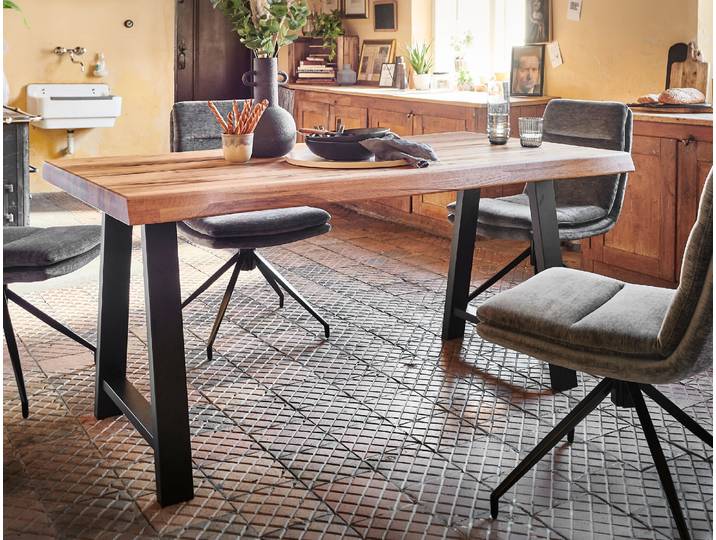
Bodahl Esstisch Hampleton aus massiver Balkeneiche - einmaliges Sonderangebot – 3%-Vorkasse-RabattBodahl Esstisch Hampleton aus massiver Balkeneiche - einmaliges Sonderangebot – 3%-Vorkasse-Rabatt. Esstisch in massiver Balkeneiche - einmaliges Sonderangebot Aufgrund eines Kundenstornos bieten wir diesen Tisch mit hohem Preisnachlass an. Jeder Tisch dieser Serie ist einzigartig und wird ausschließlich aufgrund der von Ihnen getroffenen Auswahl produziert. Das macht jeden Tisch zu einem echten Unikat, bei dem die gewollten Gebrauchsspuren und die immensen Materialstärken Ihrem Tisch eine ganz besondere individuelle Note verleihen. Die Tischplatte Material: massive Eiche, Balkeneiche Lieferbar Eiche geölt - oiled Platten lieferbar in: 40 mm Stärke (an den Kanten aufgedoppelt), mit gerader Kante Ansteckplatten in 50 cm Breite sind optional lieferbar Das Untergestell Untergestell Hampleton aus schwarzem Metall 4 x 8 cm Höhe 73 cm Breite 69 cm Maße des Tisches Der Tisch ist lieferbar in: 140 x 80 cm Höhe immer ca. 76 cm cm cm cm cm Holzart:Eiche,Wildeiche593,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
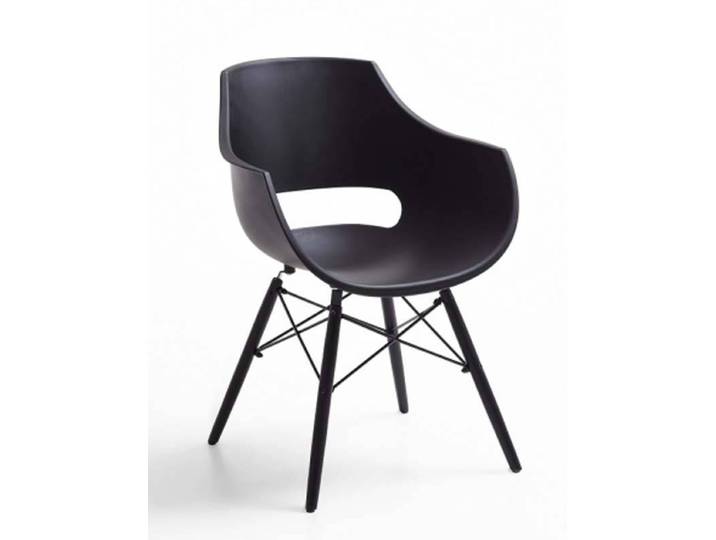
Einmaliges Sonderangebot - 4 Stühle JAZZ mit Kunststoffschale und Holzuntergestell – 3%-Vorkasse-RabattEinmaliges Sonderangebot - 4 Stühle JAZZ mit Kunststoffschale und Holzuntergestell – 3%-Vorkasse-Rabatt. Stuhl Jazz von Bodahl Material: Kunststoffschale Schwarz Beine in Echtholz schwarz Querstreben aus Metall Ausstattung: Der Stuhl ist nur im 4-er-Set lieferbar Maße des Stuhls B/H/T: ca. 57,5 / 83 / 57,5 cm Sitzhöhe - Sitztiefe 45 bzw. 46 cm Höhe Lehne: 65 cm Höhe Rückenlehne: 41 cm Platz zwischen den Lehnen: 45 cm cm cm Sitzhöhe: 40 - 45 cm cm Sitztiefe:45 - 50 cm cm319,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.